全球多区域节点互联,保障JS金沙低时延运行
依托云边端深度协同网络,实现复杂逻辑与实时图形计算的弹性负载均衡。无论面对大规模联机推演还是高并发动作交互,均可提供坚实算力调度支撑。
端云双向同步推演
针对多玩家大型虚拟空间,将物理模拟与复杂神经逻辑切分至边缘节点,客户端聚焦轻量解码与插值预测,保障网络波动下行为表现高度平滑。
自适应着色率调度
引擎根据眼动注视点与物体运动矢量,自适应调节局部网格着色精度,在视觉核心区域维持原生高精细节的同时节省 42% 的 GPU 运算开销。
全球动态资产流式推送
采用按需解密与虚拟纹理流送算法,极大缩减单客户端初始打包体积,高精度地形与动态光照烘焙数据在数秒内按视线距离完成平滑加载。
解耦微内核设计,释放JS金沙底层算力潜能
平台严格遵循现代软件工程规范,将感知推理、物理模拟、几何流送与多端编译进行模块化隔离,支持主创团队按项目规格定制组合各层驱动能力。
通过底层通用中间件统一调度 Direct3D 12、Vulkan、Metal 等图形 API,配合专门优化的张量算子库,在各品牌主流芯片平台均可发挥峰值吞吐效能。
支持强化学习模型热插拔、大规模 NPC 群体情绪感知与非线性对话逻辑即时运算。
硬件加速光线追踪、时空抗锯齿与神经辐射场几何重建一体化,实现微米级材质反光。
基于规则集与扩散算法的植被分布、多层地表侵蚀及复杂都市交通网络自动化布局。
基于实体组件系统(ECS)的极简内存布局,无垃圾回收卡顿,保障主机级稳定帧率输出。
重构内容生产范式,JS金沙六大技术突破
告别繁冗的手工硬编码,通过引入端到端协同的智能化算法链条,大幅缩短游戏原型到工业级成品的验证跨度。
神经超分抗锯齿
结合运动矢量与时序缓存,在低分辨率渲染输入下输出接近超精原生的画质,帧率平均获得 60% 至 95% 稳定提升。
行为树自动进化
虚拟角色不再依赖固化决策树,可在复杂对抗环境中进行策略自调整,营造更具沉浸感的交互战术体验。
毫秒级智能关卡生成
依据关卡节奏与数值预设,自动解算障碍物空间分布与资源补给点,保障多样化玩法体验与长周期重玩价值。
多端交叉即时编译
单套工程结构一键编译至 PC、移动终端、云游戏服务器与主流主机,内置原生代码精简与着色器预热机制。
端侧轻量化推理底座
专门压缩的张量执行运行时,安装包增量小于 12MB,内存开销低至毫厘,保障中低端手机设备平稳运行无压力。
工业级资产自动减面
十亿级高模导入后由算法自动计算拓扑结构、自动拆分 UV 并生成烘焙法线贴图,美术资产导入效率提升数倍。
量身定制的产品版本,适配不同规模商业交付要求
从敏捷轻便的独立工作室到跨国发行商的大型线上世界,JS金沙均可提供成熟稳定的商业化支撑包。
独立先锋商业版
专为小型创新工作室打造的高效开发组合,具备完整全套 PCG 工具集与轻量推理框架。
- 集成全功能实时神经物理渲染模块
- 自动化地形与场景程序化生成器
- PC、移动端双平台即时编译打包
- 标准格式资产无缝导入转换套件
企业高并发专线套件
适用于大型多人在线、强交互对抗类游戏,配备端云协同分布式推理集群与专用压测套件。
- 支持万级智能体集群无冲突实时交互
- 分布式网络同步微秒级对齐引擎
- 专属原厂架构师 1 对 1 代码调优支持
- 全平台代码级别深度交叉编译许可
工业仿真与数字孪生版
专用于交通推演、智能演训与高精物理复原项目,提供微米级物理求交与精准传感器模拟。
- 高拟真流体动力学与碰撞力学解算
- 标准 GIS 大范围数据动态流式解析
- 兼容通用工业 CAD 拓扑转换驱动
- 私有化离线闭环环境部署与安全校验
JS金沙在多元互动交互体系中的应用实效
打破传统渲染引擎与逻辑内核的割裂边界,为不同领域的交互体验开发注入前沿生成式算力支持。
高帧率移动电竞对抗
在移动芯片受限的功耗限制下,通过神经预测与精准逻辑插帧,维持百人同屏竞技 120 帧恒定无卡顿运行。
3A 规格超大开放世界
动态全局光照系统配合自动化植被流水线,实现数百平方公里连续大地图无缝漫游,零分块换地图加载时延。
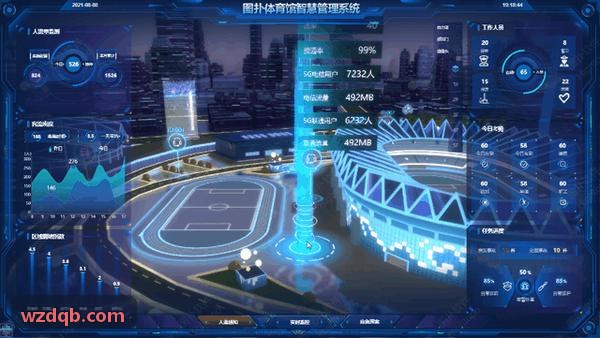
数字场馆与虚实互动
毫米级碰撞判定结合高拟真物理环境反射,为大型数字场馆提供具备物理准确性的光影交互与动态观众席推演。
即时策略战术推演系统
内置智能行为矩阵可并发评估数万种走位与战术分支,为策略竞技游戏带来真正具备战略思考的对手反应。
重构硬件调用链路,实现能耗与算力密度的极致平衡
过去十年,图形保真度的提升主要依赖硬件晶体管的粗暴堆叠。JS金沙转变这一思路,将重点转移至算法层级的时空复用与张量并行预测。
通过减少对传统冗余几何体遍历与重复阴影计算的依赖,我们在更低的功耗预算下达成了更高的光影动态深度,让次世代开发门槛全面降低。
基准性能实测对比 (4K 极限画质环境)
主程与架构师的技术攻坚现场反馈
深入实际生产管线,了解研发团队如何在JS金沙的赋能下化解工程危机、实现准时交付。
“原先我们在处理跨平台动态阴影渲染时遭遇严重的帧率骤降,移动端发热降频无法解决。切换到JS金沙的神经光照降噪模块后,不仅着色耗时压缩了一半,而且复杂的金属粗糙度反射细节甚至比手工烘焙更加细腻自然。”
“五人团队要做无缝多星系地表漫游,以往光是美术地貌与植被铺设就需要两三年。借助引擎集成的程序化生成与智能拓扑减面工具,我们两个月内完成了 12 颗不同生态行星的宏观构建,极大地释放了玩法机制的试错空间。”
传统硬编码方案与JS金沙开发效能对照
从底层算力调用、逻辑决策到多端交付,全面呈现次世代管线带来的研发流程革新。
| 对比指标 | JS金沙 | 传统固定管线引擎 |
|---|---|---|
| 光照与超分计算 | 基于时序缓存与端侧张量神经降噪,高帧率低功耗 | 纯硬件光线求交与暴力抗锯齿,高负载高发热 |
| 非玩家角色行为交互 | 自适应强化学习行为树,环境互动非线性且自然 | 预先硬编码条件分支,行为机械且极易被玩家试探摸透 |
| 复杂美术资产流送 | 工业级自动拓扑、智能减面与按视线流式解算 | 大量依赖人工分级 LOD 制作,生产耗时长且包体臃肿 |
| 跨平台打包验证耗时 | 一键交叉编译与通用着色器预热,构建周期缩短 65% | 各平台需要独立重写图形后端,联调维护成本高昂 |
| 大场景峰值内存占用 | 微内核 ECS 零 GC 内存布局,按需动态置换 | 传统面向对象冗余引用严重,易引发偶发性帧率抖动 |
关于JS金沙商业集成的常见技术解答
针对研发团队在资产迁移、性能下限、代码自主权及运行稳定性等方面的疑虑提供明确说明。
引擎完全支持 FBX、glTF、USD 等工业标准格式,并提供一键式资产解析插件,可将已有贴图、骨骼与物理约束自动转化为引擎内部的专用紧凑数据流,无需重构现有美术生产链路。
不会。引擎的端侧推理底座采用 INT8/FP16 混合量化与轻量算子剪枝,包体开销不到 12MB,并在低配设备上自动回退至低负载混合解算模式,保证最低配环境平稳稳定在 30-60FPS。
企业高并发套件及工业仿真版本均包含核心内核与工具链的完整源码授权,支持完全离线的内网自建部署,团队享有完全的二次开发与长期分支维护自主权。
依托标准 ECS 架构接口与兼容性中间层,中等规模逻辑体系的接口映射一般在两周至一个月内即可完成原型跑通,原厂技术支持团队将提供全周期现场代码审查与指导。
可以。智能逻辑推理层可原生编译为客户端本地运行时二进制文件,单机脱机模式下所有动态行为树与生成算法均在本地高速执行,不强制产生任何云端校验请求。
企业级交付支撑与长期稳定运营保障
为全球游戏开发团队与交互仿真项目提供贯穿项目立项、管线调优到正式发行的全生命周期可靠护航。
立即开启JS金沙商业评估
获取完整工程开发套件、基准性能测试包与全套架构白皮书,体验神经物理渲染与自适应推理带来的开发效率飞跃。
提交即表示申请免费 30 天完整版商业功能评估授权,无任何隐藏绑定条款。